agent沙箱与harness
Harness 是 OpenAI 在 26 年年初的一篇博客中提出的一个概念,这个词其实是从软件工程当中的 test harness 借鉴过来的一个概念。
Harness 指的是围绕 Agent 搭建的一套“护栏系统”:用确定性的规则、程序和反馈机制,约束 Agent 的不确定行为,让它长期、稳定地朝预期方向完成任务。
对于现在大模型的能力来说,给他一个任务,它可能 90% 做得很好,但会产生 10% 的 drift(偏移)。在短任务里问题可能不明显,但长期开发时,这些 drift 会不断积累,最终让代码库越来越混乱、脆弱,此前已经有相当多的例子印证了这一点,如果完全放手 vibe coding 最终只会让代码彻底失控,因此我们需要在工程上去解决这些问题。
和 harness 一起出现的一个词叫做 harness engineering,engineering 对应的是 harness 的工程实践落地,它指的是如何构建一整套系统,让 Agent 的能力能够长期、稳定、可控地转化成实际产出。随着 agent 开发发展至今,我们普遍认为一个比较成熟完善的 agent 的 harness system 应当包含以下几个组件:完善的 context 上下文管理,稳定的 tools 约束定义,memory 记忆功能,observability 可观测性以及 Eval 校验模块。
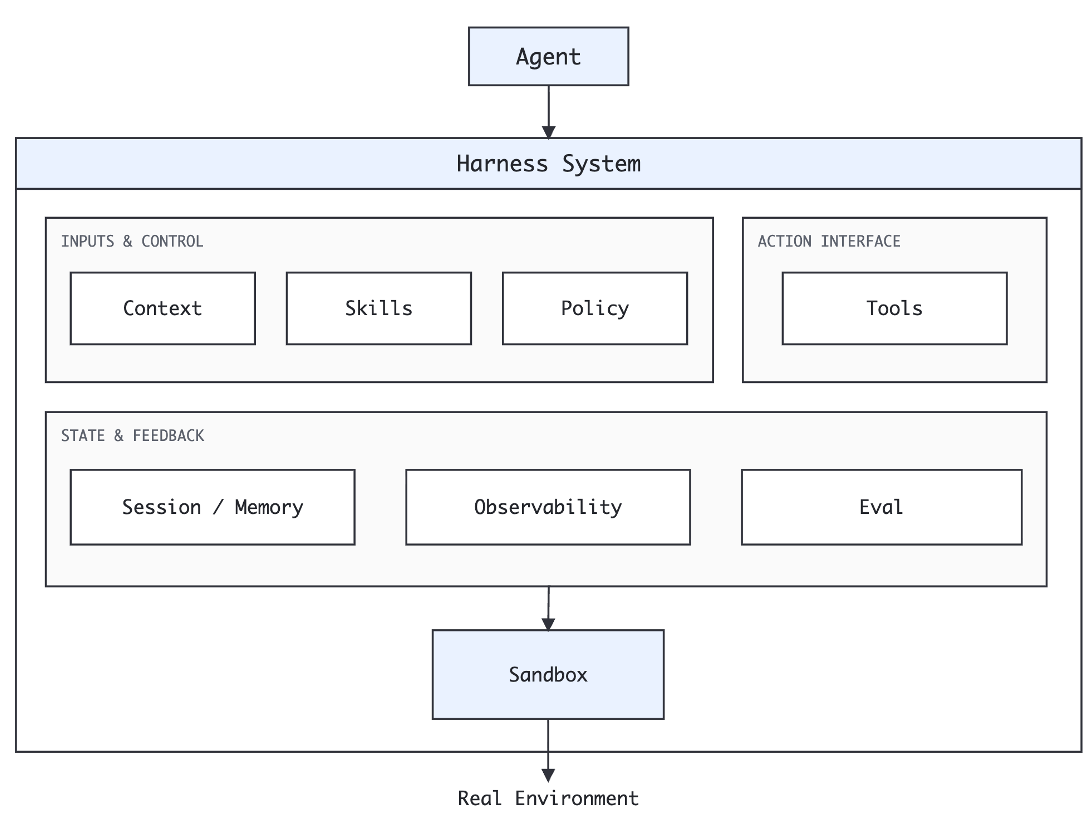
这些模块各有各的用途,但是本文的重点会围绕「agent 沙箱」展开,一方面是因为我们团队就是做 agent 沙箱业务的,另一方面是因为沙箱本身是 agent 和外界交互的关键的执行层。像 context, skill 主要负责让模型思考下一步要做什么,应该调用什么工具,执行结果是什么这些控制面的问题,而沙箱是在真实的环境中执行命令,从外界获取更多信息返回传递给大模型,从而进一步指导大模型产生下一步的决策。这也是我们说 Agent 获得 Agency(行动能力)的基础。
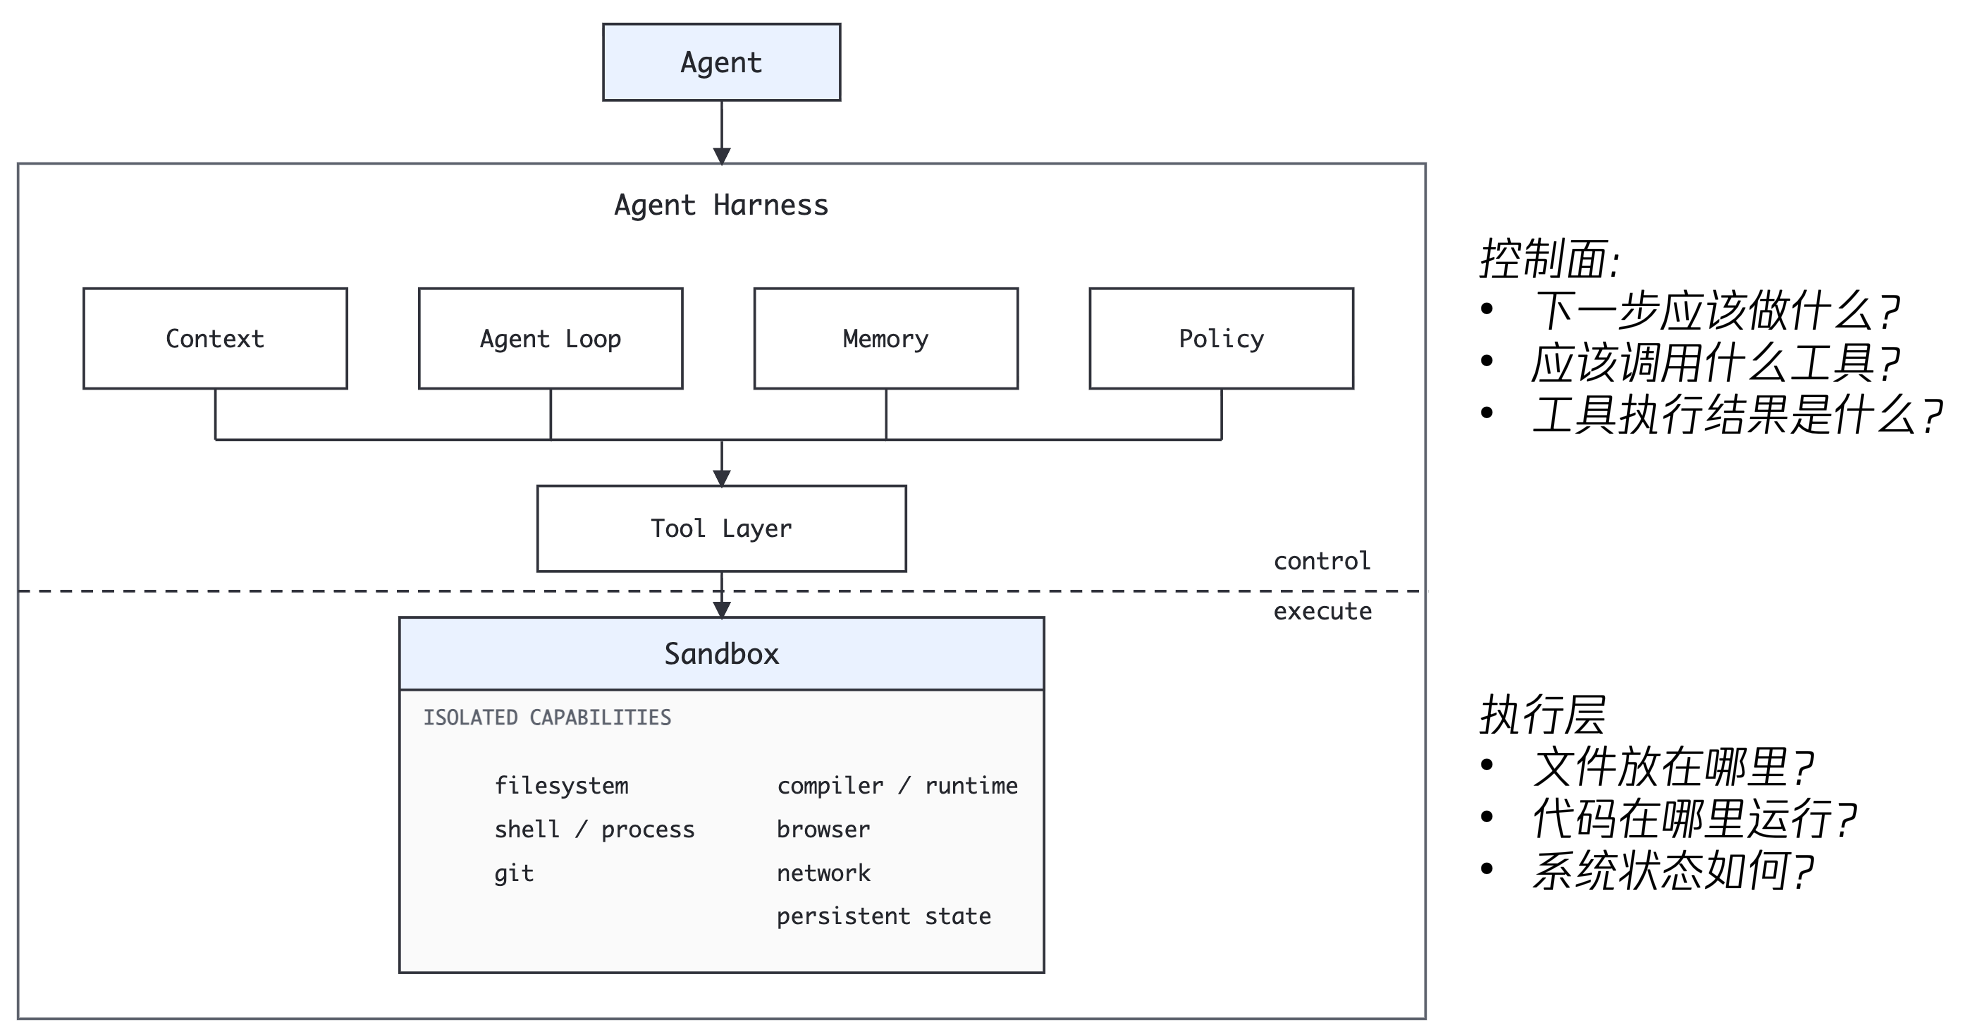
本文并不会深入沙箱的实现细节,而是会从一个宏观的角度分析一下现有的 agent 沙箱
agent沙箱何时用?怎么用?
关于「何时用」沙箱有一个很经典的问题就是"我们为什么要用沙箱?直接在环境里面执行命令不行么?"
一个很经典的回答是:agent 现在有幻觉,权限太高,可能会误删除文件或者执行危险的命令,用沙箱就可以把环境隔离开,就安全了。
「沙箱」是一种隔离的执行环境,让程序能够在受控的边界内运行,避免其行为影响宿主机或其他程序。顾名思义,我们通常就认为它是安全的,那么沙箱是用来解决安全问题吗?以及它真的能解决安全问题吗?
agent的使用场景
我们先来考虑研发中一个最常见的场景,自己的电脑里打开一个 agent 应用,比如 codex。此时 codex 可以访问本地文件,可以进行网络请求。我们普遍认为这是存在安全风险的,如果 agent 想要作恶那么可能会删除掉本地的重要文件,可能会把你的私有代码甚至密钥直接发送到网络上(zcode前车之鉴)
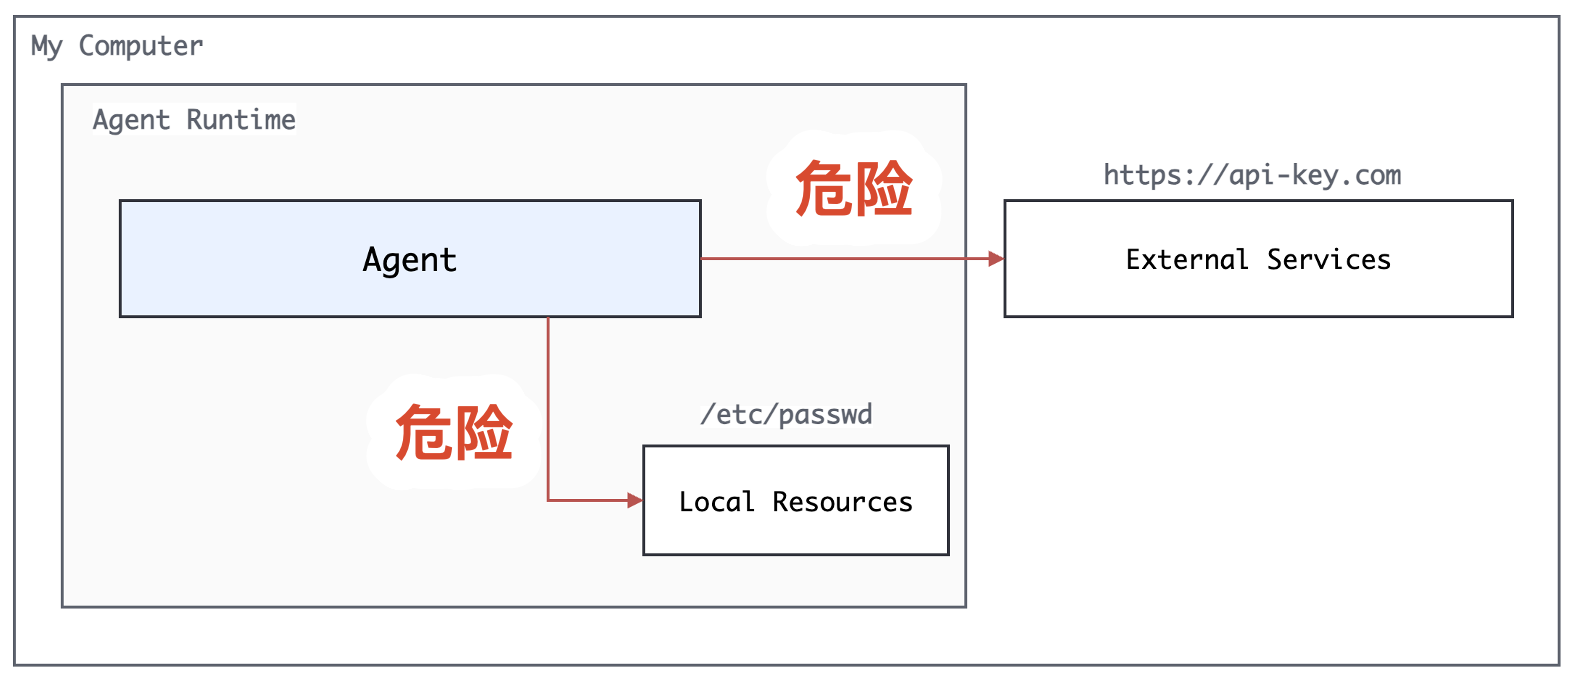
那么既然存在风险是不是我使用沙箱就可以解决安全风险呢?但实际上几乎没有人会主动打开一个Docker容器或者甚至是打开一个虚拟机把自己的Claude Code之类的这样的主力的agent的程序运行在里边,我相信绝大部分的用户在当前此时此刻其实都不是这样的一种使用的形态。
不这么做的最主要的原因是麻烦,虚拟机确实隔离了环境,但是用着用着就会发现还是需要各种文件/权限/配置/密钥,等于又在虚拟机里面装了一遍环境,久而久之这个虚拟机又变成了另一个工作台,结果 agent 还是有可能在里边删除掉你关键的文件或者执行危险的操作,绕了一大圈好像只是起到了一个形式主义。
事实上目前对于agent的很多安全问题,我们并不是通过沙箱在解决它,而是通过应用层面的权限在解决它。这些agent设计了一套权限机制,通过这种「审计」的方式,让用户在中间确认这样的一些安全风险。
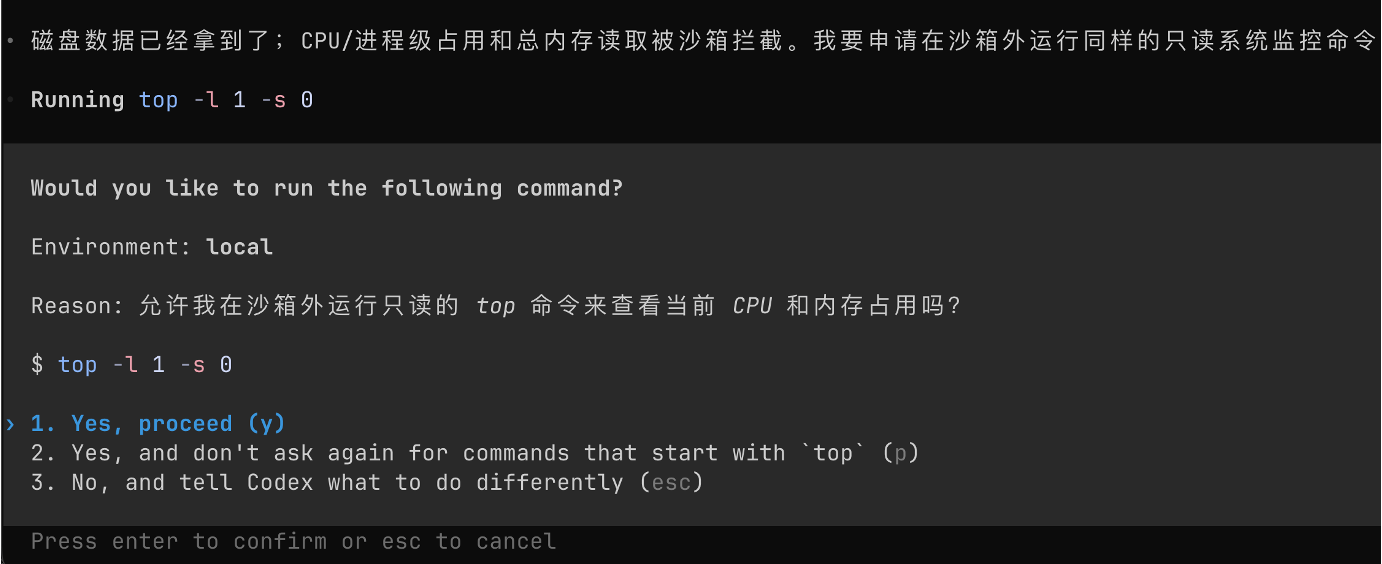
但实际上现在的 agent 越来越擅长写大段的脚本来处理一个复杂的逻辑,为了安全而去人脑审计每一条命令可以说愚蠢的可笑,可以说 agent 在95%以上的场景甚至99%以上的场景都是无害的,强行开启审计无异于自断一臂。
事实上这些本地 agent 用的只是最轻量的沙箱功能,他们会使用操作系统本身提供的隔离功能,在 linux 下使用 bubblewrap + landlock,在 mac 下使用 seatbelt,在 windows 下使用受限令牌等方式。
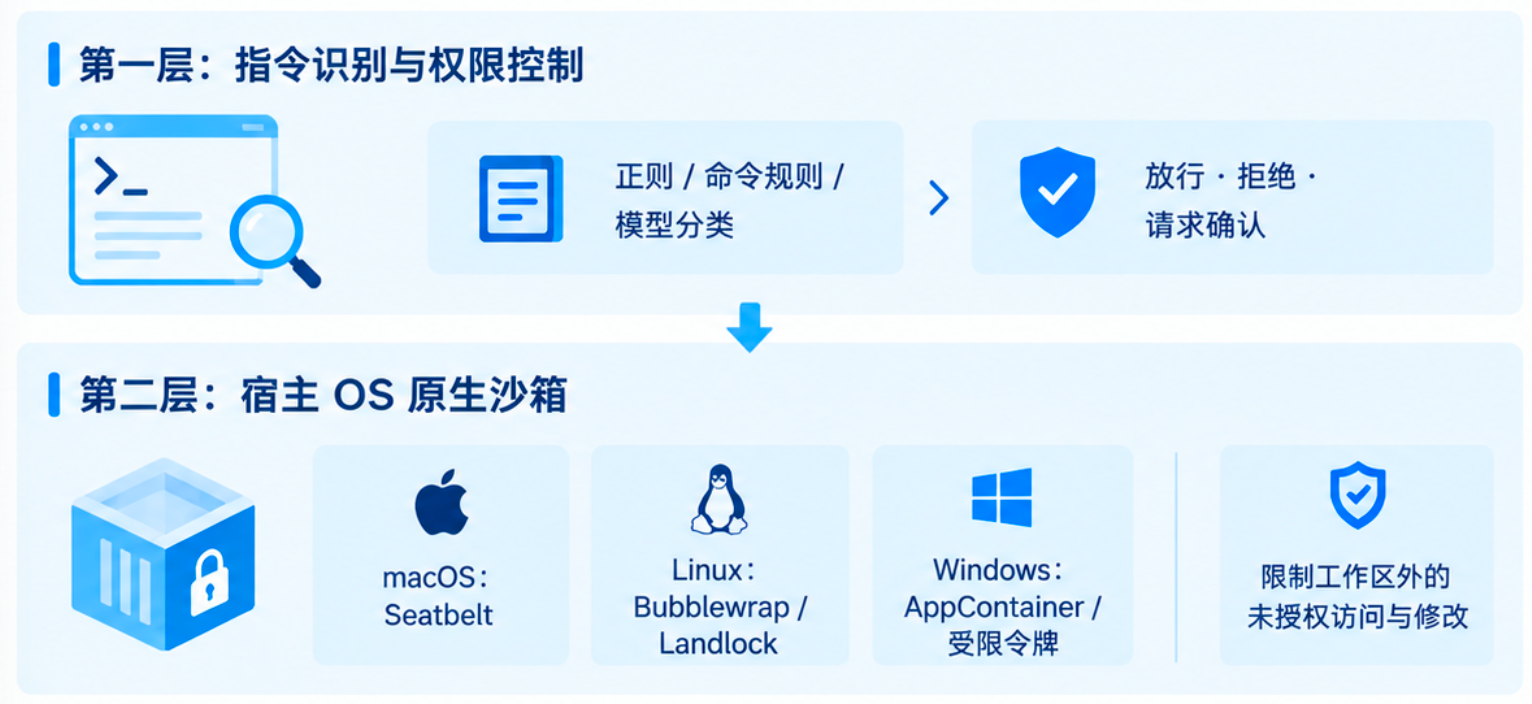
除了主动要求用户审计,还有一些 agent 会做一些简单的正则判断或者命令检查,判断是不是在执行一些高危操作(比如 rm -rf /)
以 linux 为例,如果不加任何约束直接执行代码 python main.py,那么 main.py 中可以看到和访问主机上的所有内容(如下图左侧所示),Bubblewrap(bwrap)负责“给进程造一个隔离出来的世界”,Landlock 负责“限制这个进程在文件系统里能干什么”。bwarp 可以限制这个进程只能看到 /workspace /usr /dev 这几个目录,一些敏感的目录比如 ~/.ssh ~/.config 这个进程直接就访问不到了。而 landlock 可以明确限制哪些目录可读,哪些目录可写,这样进程想去修改 /usr 也会发现没有权限操作。
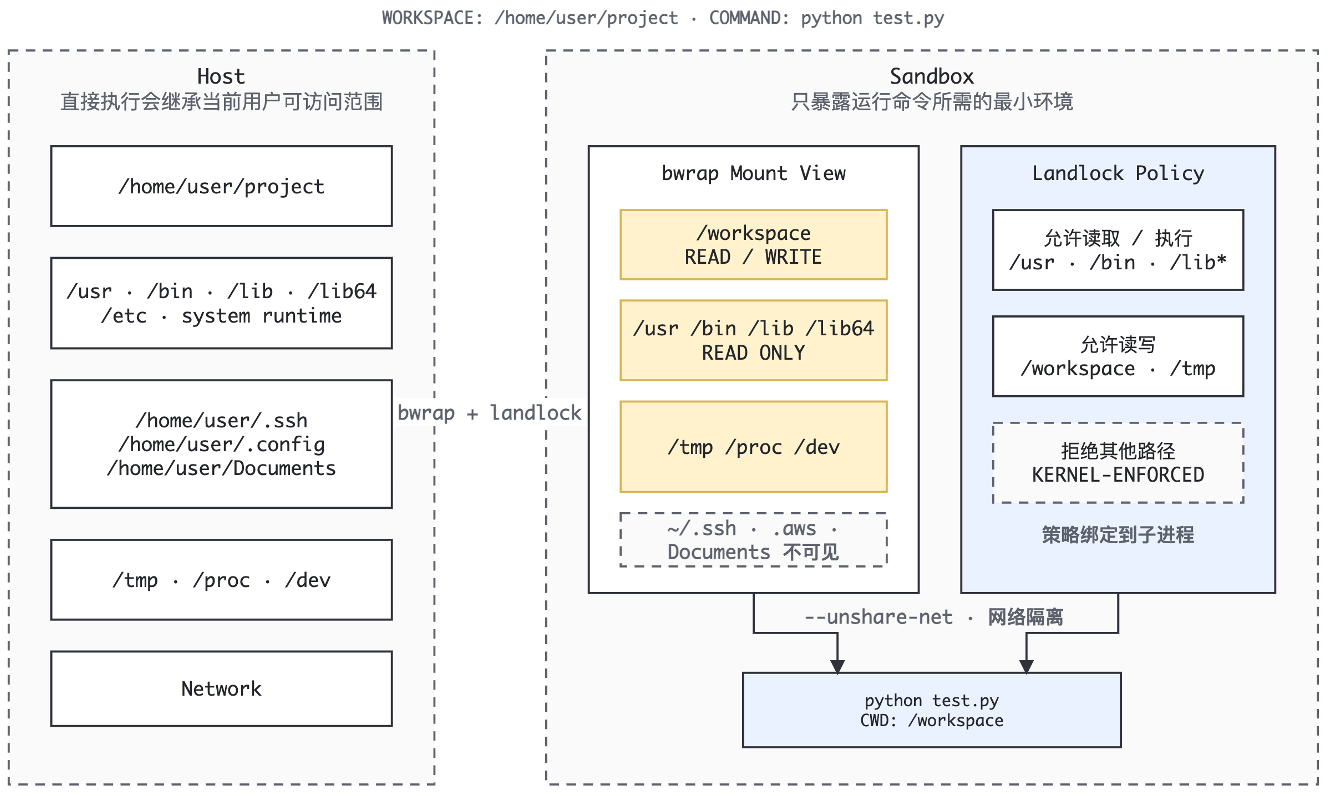
事实上如今的本地的 code agent,例如 cursor, codex, claude code 都是通过这种非常轻量级的进程限制的方式来做的安全隔离,严格来说这种并不属于我们今天提到的沙箱技术。
agent in sandbox
前文我们虽然提到了在日常使用的过程中不会主动讲
云 agent (Github Action 自动 pr) 长程任务 / persistent agent (不要动我本机的环境) AgentRL (在 sandbox 中训练,拿到 reward,用 RL 更新底层模型) 例子:DeepSWE 200次训练, 42->59 Computer Use / GUI agent (浏览器/桌面)
目前这种 agent in sandbox 的形态通常不是承载了大量复杂业务。不论是个人的还是生产级别的复杂业务的主流的形态,只是大家目前感觉这是一种比较安全的模式。但是这个边界到底应该怎么定义,怎么样不要限制过度,导致这个agent变得什么都干不了,还有很远的路要走。
但是并不是说 agent in sandbox 这种场景不存在。实际上
长程任务 / persistent agent AgentRL (在 sandbox 中训练,拿到 reward,用 RL 更新底层模型)
DeepSWE,它从 Qwen3-32B 出发,不依赖额外 SFT,而是进行 Agentic RL,让模型自己完成软件工程任务。其公开资料称,仅约 200 steps 的 RL training 就带来了显著的 SWE-bench Verified 提升;最终报告的 Pass@1 为 42.2%,结合 test-time scaling 达到 59%
Computer Use / GUI agent (浏览器/桌面)
sandbox as a tool
把沙箱当做 agent 的一个调用的工具是其最常见的使用场景,我们倾向于将主机上的一些资源临时放到一个沙箱中,在沙箱当中安全的执行命令,然后再把最终的结果返回回来,此时这个沙箱可以选择立即销毁,按照 session 销毁或者按照 task 销毁,和 agent 的实际生命周期解耦。
很多用户会访问该 BI 服务,查询数据,然后生成 html 页面预览查看
隔离用户数据
业界 agent 沙箱的用法
Sandbox 是 Agent 的「工作空间」大量状态并不需要存在 LLM Context 里,因为状态已经存在 Sandbox,因此 Sandbox 实际上承担了一部分:
External Memory / Working Memory,LLM Context
↓
短期、昂贵、token limited
Sandbox
↓
长期、便宜、可随机访问,对于长时间 Agent 任务非常重要
Sandbox 实际上可以成为 Agent 的「状态载体」
Sandbox 还可以降低 Context / Token 消耗
deepseek harness
deepseek harness 是前段时间 deepseek 开源的一个 agent 工具,介绍它一方面是因为它是 deepseek 新出的 harness 工具,吸引了很多关注。另一方面是因为 deepseek harness 确实针对现有的 agent 工具目前存在的问题提出了自己的一套解决方案。通过学习 deepseek harness 的设计架构也可以学习了解到目前 agent 工具存在的一些问题,以及针对这些问题 deepseek 给出的解法。
那为什么 LLM 领域也开始用 Harness 这个词?最主要的原因是人们发现裸的大模型不等于可用的 agent。如果只是去把大模型的对话能力接入到 agent 当中,那么实际使用下来会遇到非常多的问题,包括:
- 上下文不稳定,长任务跨多轮容易丢状态
- 工具调用不可靠,参数与权限缺少系统级校验
- 失败不可恢复,难以回放与定位
- 改动不可回归,难以稳定迭代
与此同时 LLM/Agent 最大的特点之一就是不确定性。
当然从好的方面上来讲,LLM 的创造性也是来源于这些不确定性,但是他的不确定性如果给我们带来了负面的影响那就是我们不期望的
有一种观点认为 harness 是不是只是「好的工程实践」的重命名?
harness 是面向 agent 目前存在的缺点来设计的一种解决方案,并不单纯应用在工程领域或者是coding领域,它应该是一种非常通用的设计。从另一方面我们可以说好的工程实践有非常多,我们为什么选择这些不选择那些,本质上还是从agent的自身的这种薄弱环节出发去考虑的。
业界 harness 目前存在哪些问题,做了哪些工程实践来解决这些问题
Agent 在长期、跨 Session 开发大型功能时,很容易积累 Dead Code。
主要有两个原因:
跨 Session 后不敢删除旧代码 Agent 对当前 Session 自己创建的代码比较敢于清理,但面对历史代码时,无法判断它来自人、其他 Agent 还是之前的自己,因此倾向于保守地保留。 过度考虑兼容性 Agent 容易认为旧代码“以后可能还有用”,即使已经过时,也不愿主动删除。
cordis
A Programming Paradigm for Spatiotemporal Composability
会话日志、系统提示词、工具注册表、Agent 循环、LLM 适配器——这些在传统框架中是「内核」的部分,在 dsh 中都必须是可替换的插件。这意味着不能有任何硬编码的特权组件,所有能力都必须通过统一的服务注册机制暴露。这个问题不解决,「一切皆插件」就是空谈
插件化最大的风险是组合爆炸——当几十个插件同时运行时,它们之间的交互可能产生意料之外的副作用。dsh 需要一套机制,保证插件挂载和卸载时系统状态的一致性,保证插件之间的依赖关系自动解析,保证事件的派发有序且可追溯。Cordis 的可逆副作用和类型化事件机制是解决这个问题的核心。
并不是 cleanup API 不存在,而是“做事情”和“撤销事情”是两套分离的代码
linux bwrap + landlock macos seatbelt windows 受限令牌
全文首发deepseek harness背后的秘密,Cordis的设计哲学深度解读
bwrap \
--bind /home/user/project /workspace \ --ro-bind /usr /usr \ --tmpfs /tmp \ --proc /proc \ --unshare-net \ --chdir /workspace \ python test.py
trajectory
codex as a platform
环境管理。不同任务可能需要浏览器、Shell、代码仓库、数据库甚至 GUI 环境。AgentRL 用统一的 function-call API、容器化环境、中央 Controller 和 Task Worker 来管理这些异构环境;Controller 可以单独部署,而多个 Task Worker 可以分布在不同机器甚至不同集群
多轮 rollout。模型不是生成一个答案,而是在环境中不断 interaction,采集完整 trajectory
总结
agentfs agentenv
GPT-5-Codex OpenAI明确指出GPT-5-Codex的训练流程专注于真实编程环境中的复杂任务,例如“多文件重构”“运行测试套件”与“提交PR”
Tongyi Deepreasearch 在阿里通义的技术报告中,Tongyi DeepResearch 明确强调其模型“专为智能体任务训练”而设计
Cursor 2.0 Composer 设计目标是将自然语言直接转化为可运行、可维护的完整项目。该工具以持续的、交互式的代码生成与编辑为闭环,融合了意图理解、代码生成与动态调试等多个环节
fork clone rollback 用不上?